Vous réalisez 100 ventes dans votre back-office, mais Meta, Google Ads ou TikTok n’en remontent qu’une partie.
Cela ne signifie pas automatiquement que votre tracking est défaillant. Les plateformes n’utilisent pas les mêmes règles d’attribution et leurs chiffres ne sont pas censés être parfaitement identiques.
Mais une autre partie du problème peut se situer plus tôt dans la chaîne : certains événements n’arrivent tout simplement pas jusqu’aux plateformes.
Restrictions des navigateurs, durée de vie limitée de certains cookies, bloqueurs, scripts qui ne se chargent pas correctement, parcours répartis entre plusieurs systèmes… le tracking qui repose principalement sur le navigateur rencontre aujourd’hui davantage de limites.
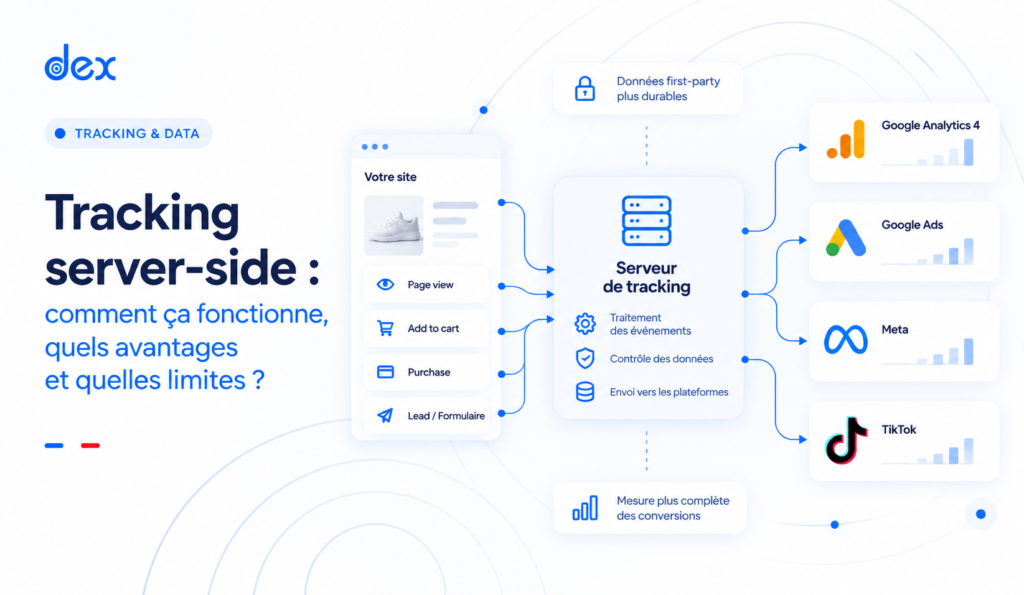
Le tracking server-side permet de reprendre une partie du contrôle en faisant transiter et traiter certains événements sur une infrastructure serveur avant de les envoyer vers Google Analytics, Google Ads, Meta, TikTok ou d’autres destinations.
L’objectif n’est pas de créer des conversions qui n’existent pas. Il est de mieux mesurer celles qui existent déjà, conserver davantage de signal dans le temps et mieux maîtriser les données transmises aux plateformes.
Qu’est-ce que le tracking server-side ?
Pour mesurer une action, il faut d’abord qu’une information existe.
Une page consultée peut générer un événement page_view. Un formulaire envoyé peut devenir un lead. Une commande peut générer un événement purchase contenant notamment une valeur, une devise, un identifiant de transaction et les produits achetés.
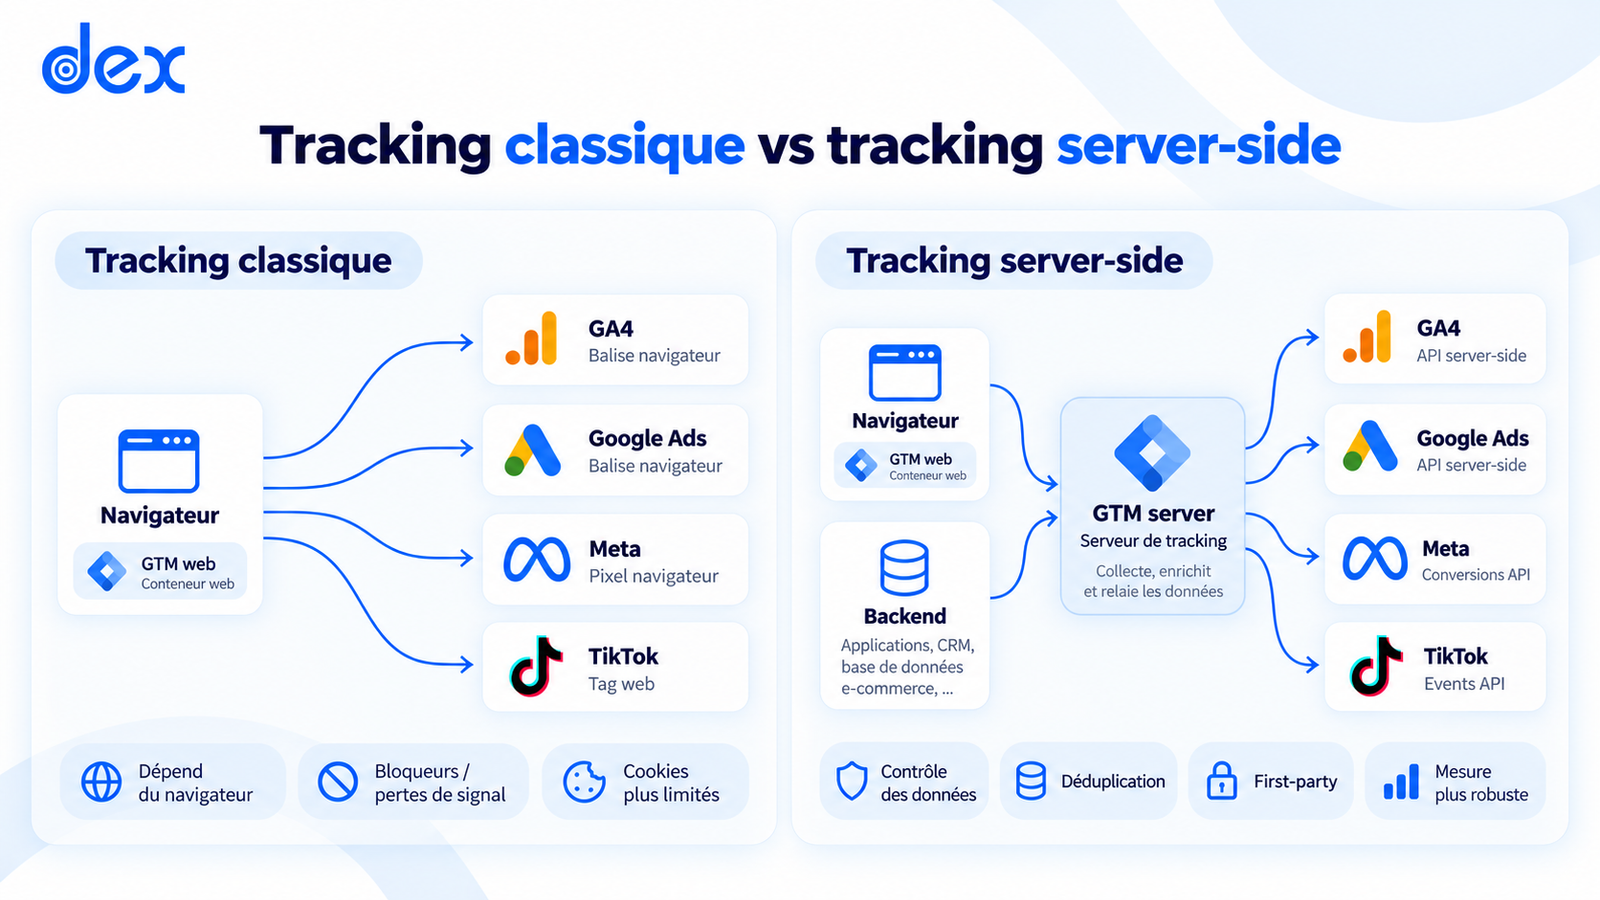
Dans une configuration classique côté navigateur, des scripts présents sur le site récupèrent ces informations et les transmettent directement aux différents outils.
Le navigateur peut alors communiquer séparément avec Google Analytics, Google Ads, Meta, TikTok ou d’autres plateformes.
Comment fonctionne le tracking server-side ?
Avec une architecture server-side, une couche supplémentaire est ajoutée entre la source de l’événement et les plateformes qui doivent le recevoir.
Une partie des données est d’abord envoyée vers une infrastructure serveur. Celle-ci reçoit les événements, les traite puis les transmet aux destinations configurées.
Google décrit le server-side tagging comme l’ajout d’une couche de traitement entre l’utilisateur et les fournisseurs marketing. Cette couche permet notamment de contrôler les données transmises aux différentes plateformes.
Le parcours peut être résumé ainsi :
Site ou système source → collecte de l’événement → traitement serveur → plateformes sélectionnées
Le serveur devient donc un point de passage et de contrôle. Il ne devient pas pour autant la source de vérité de toutes vos données.
Comment une conversion est-elle envoyée en server-side ?
Prenons un exemple simple.
Une personne achète un produit à 120 € sur un site e-commerce. Au moment où la commande est validée, plusieurs informations peuvent être disponibles :
- l’événement
purchase; - la valeur de 120 € ;
- la devise EUR ;
- un identifiant de transaction ;
- les produits commandés ;
- leurs quantités.
Dans une architecture server-side, ces informations peuvent être transmises au serveur de tracking, puis traitées pour alimenter les différentes destinations prévues.
GA4 peut recevoir l’achat pour analyser le parcours. Google Ads peut recevoir la conversion utilisée pour mesurer les campagnes. Meta peut recevoir l’événement via sa Conversions API. TikTok peut recevoir l’achat via son Events API.
Une même commande peut donc alimenter plusieurs systèmes, mais ces systèmes n’attendent pas nécessairement les mêmes paramètres ni le même format.
C’est pourquoi une installation server-side ne consiste pas simplement à « brancher une API ». Il faut partir de l’événement métier, déterminer quelle information existe à la source, puis décider ce qui doit être envoyé à chaque plateforme.
Quelle est la différence entre tracking client-side et server-side ?
La différence principale tient à l’endroit où une partie de la collecte et du traitement est réalisée.
En client-side, le navigateur joue un rôle central : il charge les scripts et transmet directement une partie des données aux plateformes. En server-side, une infrastructure serveur s’intercale dans le parcours pour recevoir, traiter et router certains événements.
Les deux approches peuvent d’ailleurs coexister. Le server-side ne signifie pas nécessairement que le navigateur disparaît de la chaîne.
Pourquoi le tracking client-side peut-il perdre une partie du signal ?
Lorsqu’un utilisateur consulte un site, différents scripts doivent se charger et s’exécuter avant d’envoyer leurs informations aux plateformes.
Cette chaîne peut être perturbée de plusieurs façons : un bloqueur peut empêcher certains scripts de fonctionner, une requête vers une plateforme peut ne pas partir, un navigateur peut limiter l’utilisation de certains cookies ou un identifiant peut ne plus être disponible lorsque l’utilisateur revient plusieurs jours après sa première visite.
Une partie du parcours devient alors plus difficile à relier à la conversion finale.
C’est notamment sur cette dépendance au navigateur que le server-side peut agir.
Tracking server-side et Safari : que change l’ITP d’Apple ?
Safari est probablement l’exemple le plus parlant de l’évolution des restrictions navigateur.
Apple, via WebKit, utilise Intelligent Tracking Prevention, ou ITP, pour limiter les mécanismes permettant de suivre un utilisateur entre plusieurs sites.
Combien de temps les cookies peuvent-ils durer sur Safari ?
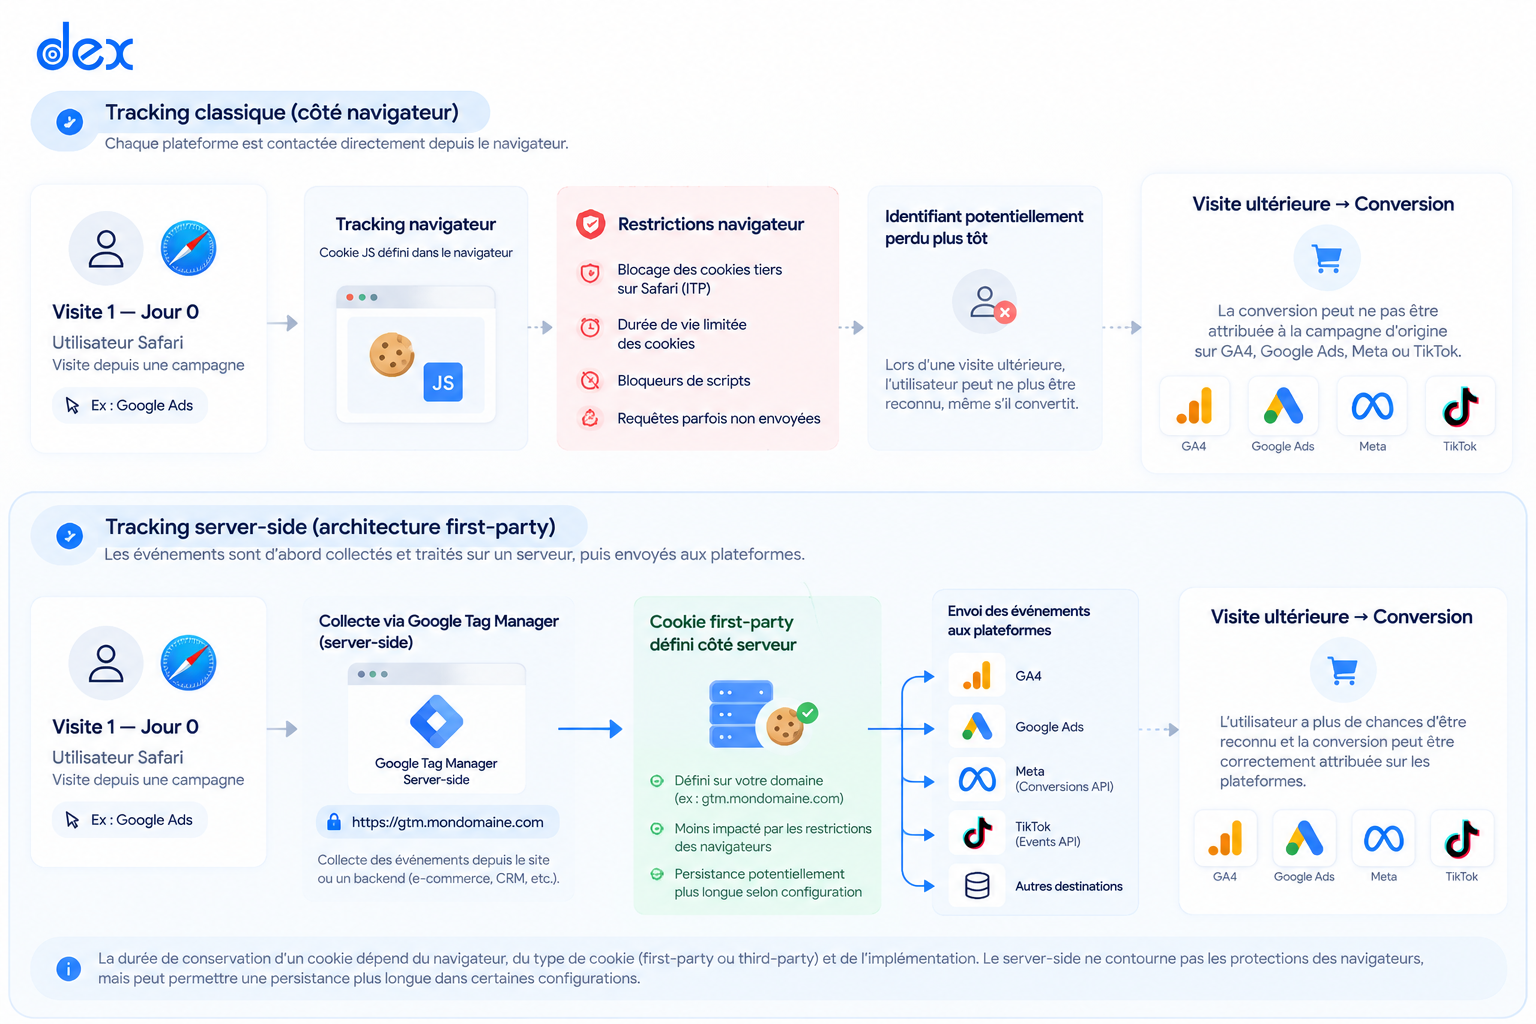
Safari bloque les cookies tiers. WebKit applique également une limite de 7 jours sans interaction avec le site aux cookies créés en JavaScript et à d’autres formes de stockage accessibles aux scripts.
Dans certains scénarios de suivi utilisant des paramètres ajoutés dans les liens — le link decoration — la durée de certains cookies JavaScript peut même être limitée à 24 heures.
Prenons un parcours fréquent : une personne clique sur une publicité depuis son iPhone, découvre la marque mais n’achète pas, revient quelques jours plus tard, compare à nouveau les produits puis achète lors d’une visite ultérieure.
Pour l’entreprise, il s’agit d’un seul parcours d’achat. Mais pour les outils marketing, il faut être capable de conserver suffisamment d’informations entre les visites pour relier les différentes étapes.
Lorsque certains identifiants disparaissent trop tôt, une partie de cette continuité peut être perdue. La vente existe toujours dans Shopify, WooCommerce ou le système métier, mais la plateforme publicitaire peut disposer d’une vision moins complète de ce qui a précédé l’achat.
Le server-side peut-il augmenter la durée de vie des cookies ?
Dans une architecture configurée en contexte first-party, certains cookies peuvent être définis directement par le serveur au lieu d’être uniquement créés par JavaScript dans le navigateur.
Google recommande l’utilisation d’un domaine propriétaire pour le serveur de tagging afin de bénéficier notamment des avantages de sécurité et de durabilité des cookies définis côté serveur.
Il n’existe toutefois pas de durée universelle pour un cookie server-side. Elle dépend du cookie, de la plateforme, de l’architecture, du navigateur et de la manière dont l’identifiant est géré.
Certaines solutions permettent de prolonger des cookies spécifiques. Stape documente par exemple, avec son outil Cookie Keeper, des durées différentes selon les identifiants : 90 jours pour plusieurs cookies Google Ads et Meta, 13 mois pour _ga ou _ttp, et jusqu’à 400 jours pour certains cookies pris en charge.
Ce sont les caractéristiques d’une solution et de cookies précis, pas une propriété automatique de tout tracking server-side.
L’intérêt business est de pouvoir mieux relier des visites espacées dans le temps lorsque le cadre de collecte et l’implémentation le permettent.
Cela peut améliorer la continuité de l’attribution, du reporting et de certains usages publicitaires.
Le tracking server-side permet-il de contourner Safari ?
Non. Mettre en place du server-side ne signifie pas neutraliser les protections d’Apple.
WebKit prévoit également des mécanismes pour détecter certaines techniques destinées à masquer des services tiers derrière des domaines first-party.
Dans les situations de CNAME cloaking ou de cloaking d’adresse IP identifiées comme tierces, Safari peut notamment plafonner à sept jours la durée de cookies définis dans la réponse HTTP.
L’intérêt du server-side n’est donc pas de contourner Safari, mais de construire une collecte first-party plus robuste et mieux maîtrisée dans un environnement où les navigateurs réduisent progressivement les possibilités de tracking tiers.
Quels sont les avantages du tracking server-side ?
Les bénéfices du server-side concernent principalement la mesure des conversions, la qualité du signal transmis aux plateformes et le contrôle des flux de données.
Le server-side permet-il de mesurer davantage de conversions ?
Oui, lorsque les conversions manquantes proviennent de pertes de signal que l’architecture server-side permet de réduire.
Supposons qu’un e-commerce enregistre 1 000 commandes dans son système métier, mais que la plateforme publicitaire n’en observe que 800.
Les 200 commandes restantes n’ont pas disparu : elles ont bien eu lieu, mais une partie du signal n’est pas arrivée jusqu’à la plateforme.
Selon la cause de cette perte, une transmission serveur peut permettre d’en récupérer une partie.
TikTok explique que les incohérences du navigateur ou les problèmes de connectivité peuvent affecter les conversions remontées via son Pixel et que l’Events API peut permettre de reporter davantage de conversions, ensuite utilisées pour la mesure, le ciblage et l’optimisation.
Il faut toutefois distinguer davantage de conversions mesurées et davantage de conversions générées.
Le tracking server-side peut augmenter le premier chiffre. Il ne crée pas directement le second.
Comment le server-side aide-t-il les algorithmes de Google Ads, Meta et TikTok ?
La qualité du tracking ne sert pas uniquement au reporting. Les conversions transmises sont également utilisées par les plateformes publicitaires pour optimiser certaines campagnes.
Google Ads utilise notamment les données de conversion dans ses stratégies d’enchères automatisées comme Target CPA, Maximize Conversions ou Target ROAS.
Imaginons qu’une campagne produise 100 achats, mais que Google Ads n’en reçoive que 70. Pour l’entreprise, les 30 achats restants existent. Pour l’algorithme publicitaire, ils ne font pas partie du signal disponible pour cette campagne.
Si une meilleure architecture permet de transmettre correctement une partie de ces événements manquants, le système dispose d’une information plus complète sur les conversions associées aux campagnes.
TikTok suit la même logique en utilisant ses événements web pour la mesure mais aussi pour l’optimisation de la diffusion publicitaire.
Cela ne garantit pas qu’ajouter du server-side fera automatiquement baisser votre CPA. Une campagne mal ciblée, une offre peu attractive ou une landing page qui convertit mal restent des problèmes indépendants du tracking.
Mais un algorithme qui optimise sur des conversions a intérêt à recevoir un signal de conversion aussi fiable et complet que possible.
Le server-side permet-il de mieux contrôler les données envoyées aux plateformes ?
Oui. L’infrastructure serveur ajoute un point de contrôle entre la collecte et les plateformes.
La couche serveur permet, selon l’architecture, de :
- choisir les paramètres transmis ;
- supprimer certaines informations ;
- transformer des valeurs ;
- enrichir un événement à partir d’une information disponible côté serveur ;
- router un événement vers plusieurs destinations ;
- appliquer des traitements différents selon la plateforme.
Une commande reste donc une seule réalité métier, mais ses données peuvent être préparées différemment avant d’être envoyées vers GA4, Google Ads, Meta ou TikTok.
Quelles sont les limites du tracking server-side ?
Le server-side améliore certaines parties de la collecte, mais il ne corrige pas automatiquement toutes les limites du tracking.
Le tracking server-side remplace-t-il le tracking côté navigateur ?
Pas nécessairement.
Dans une architecture sGTM classique, le navigateur peut continuer à générer certains événements. Un utilisateur clique sur un bouton, le site détecte l’action, une information entre dans la data layer, le conteneur web l’envoie au serveur, puis le serveur la traite et la transmet aux destinations prévues.
D’autres événements peuvent en revanche être générés directement depuis le backend. Une commande confirmée dans un système e-commerce, une réservation validée dans un moteur externe ou un lead qualifié dans un CRM peuvent parfois être transmis depuis ces systèmes.
Le choix doit donc se faire événement par événement : quelle est la source la plus fiable pour cette information ?
Comment éviter le double comptage des conversions ?
Combiner navigateur et serveur présente un avantage, mais crée aussi un risque : compter deux fois le même événement.
Le Pixel d’une plateforme peut transmettre un achat depuis le navigateur, tandis que la même commande est également envoyée via une API serveur.
Si la plateforme ne peut pas reconnaître qu’il s’agit du même achat, deux événements peuvent apparaître pour une seule vente.
C’est le rôle de la déduplication. Les plateformes disposent de mécanismes permettant de reconnaître plusieurs transmissions correspondant au même événement, notamment grâce à des identifiants cohérents.
L’installation doit donc vérifier non seulement que l’événement part bien, mais aussi qu’il est reçu et comptabilisé correctement. Une balise qui « fire » dans GTM n’est pas, à elle seule, une preuve que le tracking fonctionne.
Pourquoi GA4, Meta et Google Ads affichent-ils des conversions différentes ?
Même avec une installation correcte, vos plateformes continueront probablement à afficher des chiffres différents.
Votre système métier peut compter une commande au moment où elle est créée. GA4 utilise ses propres règles pour analyser les événements et leurs sources. Google Ads applique ses paramètres et modèles d’attribution. Meta utilise également ses propres fenêtres et règles de comptage.
Le tracking server-side améliore la circulation de l’événement. Il n’unifie pas les règles de reporting des plateformes.
L’objectif n’est donc pas nécessairement d’obtenir GA4 = Google Ads = Meta = back-office, mais de comprendre pourquoi les chiffres diffèrent et de vérifier que les événements nécessaires arrivent correctement dans chaque système.
Le server-side peut-il corriger une mauvaise donnée à la source ?
Non. Une couche serveur ne peut traiter que les informations qu’elle reçoit ou qu’elle peut récupérer auprès d’autres systèmes.
Si votre site envoie une valeur de commande incorrecte, le serveur ne la rendra pas juste par magie. Si aucun identifiant de transaction fiable n’existe, il ne pourra pas toujours résoudre les problèmes de doublons.
Et si une réservation est finalisée dans un moteur externe qui ne fournit aucune information exploitable, installer un conteneur server-side uniquement sur le site principal ne permettra pas de reconstruire la réservation.
C’est pourquoi un projet de tracking doit commencer par le parcours métier : quelles actions voulons-nous mesurer, où l’information existe-t-elle et comment peut-elle être récupérée ?
Tracking server-side et RGPD : le consentement reste-t-il obligatoire ?
Le passage par un serveur ne supprime pas les obligations liées à la collecte et à l’utilisation des données.
Le fait qu’un cookie soit first-party, qu’une information soit hachée ou qu’une requête parte depuis une infrastructure serveur ne rend pas le consentement facultatif lorsque celui-ci est requis.
En France, la CNIL rappelle notamment que les traceurs publicitaires nécessitent en principe le consentement préalable de l’utilisateur, hors cas d’exemption prévus par la réglementation. Consulter les règles de la CNIL sur les cookies et autres traceurs.
La CMP, le Consent Mode et l’architecture server-side remplissent donc des fonctions différentes. La CMP recueille et conserve les choix, les mécanismes de consentement transmettent les états nécessaires aux outils, et le serveur doit respecter ces choix dans les flux qu’il traite.
Le tracking server-side peut-il améliorer les performances du site ?
Il peut y contribuer.
Une architecture server-side permet de déplacer certains traitements hors du navigateur. Moins de scripts tiers exécutés côté utilisateur peut signifier moins de travail pour le navigateur.
Google cite l’amélioration des performances parmi les bénéfices du server-side tagging : déplacer une partie du traitement vers le serveur peut réduire la quantité de code de mesure exécutée côté client.
Mais le résultat dépend de l’implémentation. Créer un conteneur serveur tout en conservant exactement les mêmes scripts et traitements dans le navigateur ne garantit pas une amélioration visible des performances.
Combien coûte le tracking server-side ?
Le server-side ajoute une infrastructure et donc des coûts supplémentaires. Ils ne se limitent pas à l’installation initiale.
Selon le projet, il faut notamment prévoir :
- l’hébergement de l’infrastructure serveur ;
- la définition ou la reprise du plan de marquage ;
- la configuration des événements ;
- les connexions aux plateformes ;
- les tests ;
- le contrôle de la déduplication ;
- la gestion du consentement ;
- la documentation ;
- la maintenance lorsque le site ou les plateformes évoluent.
Le coût de l’infrastructure dépend ensuite du volume de requêtes et de la solution utilisée. Stape, Google Cloud ou d’autres infrastructures peuvent par exemple être utilisées pour héberger un conteneur server-side.
Un e-commerce qui envoie des millions d’événements vers plusieurs plateformes n’a pas le même besoin qu’un site de génération de leads avec trois conversions principales.
Comment vérifier qu’un tracking server-side fonctionne correctement ?
La vérification doit suivre l’événement jusqu’au bout.
Prenons une commande test. Il faut vérifier :
- que la commande est bien créée dans le système métier ;
- que le bon événement est généré ;
- que sa valeur, sa devise et son identifiant sont corrects ;
- qu’il atteint l’infrastructure serveur ;
- que les règles prévues y sont appliquées ;
- qu’il est transmis aux bonnes destinations ;
- que chaque plateforme le reçoit ;
- qu’il n’est pas compté deux fois ;
- que le comportement est cohérent avec le choix de consentement ;
- qu’il peut être rapproché de la transaction métier lorsque ce contrôle est possible.
Les outils de preview, les logs et les interfaces de diagnostic sont indispensables.
Mais un score vert ou un tag déclenché ne prouve pas à lui seul que toute la chaîne est correcte.
La meilleure vérification consiste à partir d’un événement connu et à suivre son parcours jusqu’à sa destination.
Faut-il passer au tracking server-side ?
Le server-side devient intéressant lorsqu’il répond à un problème identifié.
Par exemple :
- des conversions existent dans le système métier mais une partie ne remonte pas dans les plateformes ;
- Safari et les restrictions navigateurs réduisent la continuité de certains signaux ;
- Meta, Google Ads ou TikTok occupent une place importante dans l’acquisition et dépendent fortement des données de conversion ;
- plusieurs plateformes doivent recevoir les mêmes événements ;
- les données doivent être davantage contrôlées avant leur transmission ;
- certains événements fiables existent dans le backend, un CRM ou un moteur de réservation ;
- le nombre de scripts exécutés côté navigateur doit être réduit.
À l’inverse, ajouter une infrastructure server-side sans savoir quel problème elle doit résoudre peut simplement ajouter du coût et de la complexité.
La première question à poser n’est donc pas « comment installer du tracking server-side ? », mais « quelles données manquent aujourd’hui pour mesurer et piloter correctement notre acquisition ? »
C’est à partir de ce diagnostic que l’architecture peut être définie.
Chez dex, nous commençons par examiner le parcours de conversion, les événements disponibles, les pertes de signal et les plateformes à alimenter avant de définir l’installation server-side adaptée.